日志检索三家实测:压缩比差距有一半不是日志本身
4908 字 · 约 13 分钟
日志场景说到头就关心两件事:存下来要多少盘,查起来有多快。网上能找到的对比材料不少,可口径往往对不上。压缩比的分母,有的算原始日志字节,有的算数据库自报的「压缩前大小」;配置档位有的比开箱默认,有的比调优极限;查询本身也不等价,一家走索引一家全表扫,最后比出来的是配置差异,不是引擎差异。
所以我自己测了一轮。同一台机器、同一份数据、同一组查询,ClickHouse、Doris、Elasticsearch 三家,只比存储成本和全文检索速度,不比写入。两份合成日志各 1 亿行,一共 2 亿行、38 GiB 原始数据。
测之前得先弄清楚三家在架构上差在哪,后面的结果基本都是从这里来的:
| 倒排索引存不存 token 位置 | 短语检索 | 原文存储 | |
|---|---|---|---|
| Elasticsearch | 存 | 精确 | _source 默认另存一份完整原文 |
| ClickHouse | 不存 | 只能近似,或放弃索引回读原文列 | 列存本身就是原文 |
| Doris | 建表参数 support_phrase 控制 | 开启时精确,关闭后短语查询直接报错 | 列存本身就是原文 |
存位置,索引就大,换来的是短语能力;不存,索引小,短语查询要么近似,要么回去扫原文。后面压缩比和检索速度上的差别,大多能追到这里。
怎么测的
环境是单机,48 核 / 251 GB 内存。版本是 ClickHouse 26.3.13.31、Apache Doris 4.0.8、Elasticsearch 9.5.1,并发始终是 1。
数据用的是 nginx access log(25.587 GiB)和 /var/log/messages(12.586 GiB),各 1 亿行,跨 7 天。检索用的探针词和短语是随机生成后注入进去的,除了注入的位置,语料里别处都不会出现,这样每条查询该返回多少行,都能精确算出来。
数据经采集后以 JSON 落库,除了日志正文 message,还带着采集端补的 6 个元数据字段(采集时刻、路径、主机名、IP、topic、文件哈希),外加 2 个校验用的序号字段。
配置分五档:
| 档位 | 含义 | ClickHouse | Doris | Elasticsearch |
|---|---|---|---|---|
| d0 | 压缩算法吃默认值 | MergeTree 默认 LZ4 | 默认段压缩 | 默认 codec |
| t1 | 调压缩算法 | 全列 ZSTD(3) | compression=zstd | best_compression + logsdb |
| t2a | 调分词器 A | unicode_word | parser=unicode | ICU 分词 |
| t2b | 调分词器 B | ngrams(3) | parser=chinese | CJK 分词 |
| t3 | 极限压缩 | 全列 ZSTD(9) | 关闭短语索引 | 关闭 _source |
d0 不是「开箱默认」。三家在 d0 都已经显式配好了索引、分片数、排序键,只有压缩算法留空吃默认值,隔离的变量只有这一个。t3 三家各用各的手段换空间,代价也各不相同,看体积的时候要连着能力变化一起看。
口径上我卡了三条。压缩比的分母只认原始日志文件的字节数,数据库自报的「压缩前大小」、中间文件大小一律不算,分子是完整的存储占用,含索引。查询必须等价才拿来比:612 条候选查询里,有 30 条在某一家跑不了,24 条能跑但结果集对不上,这 54 条全部剔掉,最后用的是 558 条,每条的返回行数都跟真值对过。延迟取三批重复测量的中位数,三批用不同的随机种子、打乱查询顺序,两家的三批结果范围要是有重叠,就算分不出高下,不拿来排名。
压缩比
落盘 ÷ 原始,越小越好,括号里是压缩倍数。
nginx(原始 25.587 GiB):
| 档位 | ClickHouse | Doris | Elasticsearch |
|---|---|---|---|
| d0 | 27.25%(3.67×) | 43.49%(2.30×) | 71.07%(1.41×) |
| t1 | 25.04%(3.99×) | 42.62%(2.35×) | 47.11%(2.12×) |
| t2a | 23.27%(4.30×) | 37.10%(2.70×) | 46.95%(2.13×) |
| t2b | 90.14%(1.11×) | 38.45%(2.60×) | 47.02%(2.13×) |
| t3 | 23.21%(4.31×) | 30.81%(3.25×) | 24.55%(4.07×) |
messages(原始 12.586 GiB):
| 档位 | ClickHouse | Doris | Elasticsearch |
|---|---|---|---|
| d0 | 69.66%(1.44×) | 55.89%(1.79×) | 116.89%(0.86×) |
| t1 | 47.80%(2.09×) | 53.49%(1.87×) | 79.03%(1.27×) |
| t2a | 50.97%(1.96×) | 57.00%(1.75×) | 78.98%(1.27×) |
| t2b | 134.07%(0.75×) | 57.28%(1.75×) | 78.38%(1.28×) |
| t3 | 44.95%(2.22×) | 43.44%(2.30×) | 47.64%(2.10×) |
ES 另外还有一档 t1_trial(nginx 37.62%),用 synthetic _source 把原文改成按需重建、不直接存,索引总量比 t1 再省 20.14%,不过得有企业版或试用许可证。
两处超过了 100%
先看 CK 的 messages_t2b,134.07%。3-gram 分词会把文本切成所有相邻 3 个字符的窗口,窗口数比词数多得多。它的索引有 15.06 GB,而被索引的那一列才 3.05 GB,索引比原文大了将近 5 倍。换来的是对中文这种没有天然分词边界的语言的子串召回能力。
再看 ES 的 messages_d0,116.89%。拆到字段级一看,_source(完整原文)占了 57.74%,_id(每个文档唯一 ID 的倒排加存储)占了 9.16%,两项加起来 66.9%,message 字段本身只占 24.90%。
| 索引 | _source | _id | message | 其余 |
|---|---|---|---|---|
| messages_d0 | 57.74% | 9.16% | 24.90% | 8.21% |
| messages_t1 | 49.92% | 9.94% | 34.33% | 5.82% |
| messages_t3 | 已禁用 | 19.02% | 61.09% | 19.90% |
| nginx_d0 | 64.20% | 7.39% | 21.71% | 6.69% |
| nginx_t1 | 54.64% | 8.20% | 32.35% | 4.81% |
这也不能简单算成浪费。_source 换来的是整条取回原文、_reindex、_update 的能力,_id 换来的是按 ID 精确更新和删除单条文档。CK 和 Doris 走列存路线,原生就不提供这两样,自然也没有这份开销。日志只追加、从来不按 ID 改,这两样确实用不上,但那是日志场景用不上,不代表这些能力本身没用。
只存日志正文的话
上面的数字里,包含了采集链路补的 6 个元数据字段和 2 个校验字段。为了把日志正文本身的成本单独拎出来,我又建了一组表,只留 message 一列(全文索引照建),导入同一份 1 亿行数据,测了 d0 和 t1 两档。落盘数字含索引,跟主表口径一致。
| 完整字段 | 仅日志正文 | 元数据占落盘 | |
|---|---|---|---|
| CK nginx_d0 | 27.25% | 26.00% | 4.57% |
| CK nginx_t1 | 25.04% | 25.00% | 0.16% |
| CK messages_d0 | 69.66% | 63.18% | 9.31% |
| CK messages_t1 | 47.80% | 47.72% | 0.17% |
| Doris nginx_d0 | 43.49% | 41.94% | 3.57% |
| Doris nginx_t1 | 42.62% | 41.96% | 1.53% |
| Doris messages_d0 | 55.89% | 52.32% | 6.38% |
| Doris messages_t1 | 53.49% | 52.04% | 2.72% |
| ES nginx_d0 | 71.07% | 58.73% | 17.36% |
| ES nginx_t1 | 47.11% | 33.39% | 29.11% |
| ES messages_d0 | 116.89% | 91.99% | 21.31% |
| ES messages_t1 | 79.03% | 56.09% | 29.03% |
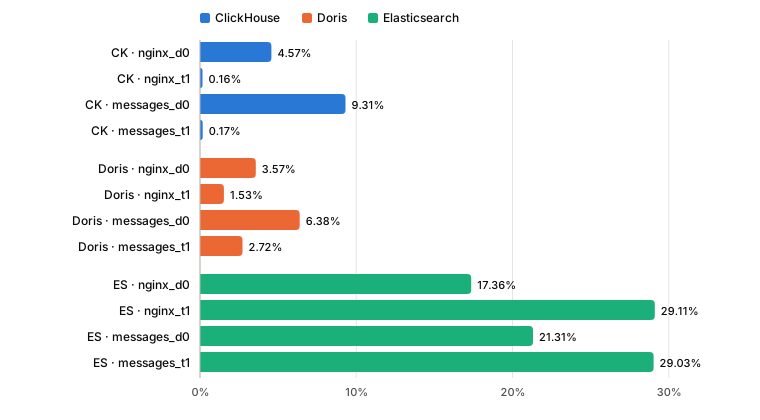
三家差了两个数量级,方向还是反的。CK 和 Doris 调优以后,元数据的占比降下来了,时间戳和序号这种列被编码压到几乎为零。ES 调优以后反倒升到了 29%:best_compression 把倒排索引压小了,可 _source 里那份元数据是按 JSON 整体存的,压缩收益小得多,在总量里的分量就显得更重了。
原因从 ES 的字段构成里看得很清楚。就算索引里只剩一个字段,日志正文还是存了两份。nginx_t1 的仅正文索引里,原文副本占 47.14%,倒排索引占 45.66%,_id 占 6.63%。CK 其实也存了两份,列存原文加跳数索引,区别在于 ES 多了一份 _id,而且两份都更大。
索引在这组表里占的比例也不小:
| 索引占「仅日志正文」落盘 | nginx_d0 | nginx_t1 | messages_d0 | messages_t1 |
|---|---|---|---|---|
| ClickHouse(跳数索引) | 41.8% | 43.5% | 39.8% | 52.7% |
| Doris(倒排索引) | 46.6% | 46.6% | 45.0% | 44.7% |
| Elasticsearch(倒排索引) | 25.6% | 45.6% | 30.8% | 48.4% |
也就是说,存一份日志正文、让它能被全文检索,索引就要占掉四到五成的盘。ES 在 d0 档占比明显低一些,不是它的索引小,而是同一档下 _source 那份原文更大,把分母抬高了。
三家的索引字节取法不一样。CK 取的是 system.data_skipping_indices 里 idx_msg 的压缩字节;ES 取的是 _disk_usage 里 message 字段的 inverted_index 分量;Doris 的 SHOW DATA 只到表级,我改成按文件类型统计,列存 .dat、倒排 .idx,逐个 tablet 加起来。
回到开头那个数字。t1 档 CK 和 ES 的压缩比,完整字段下是 25.04% 对 47.11%,差 1.88 倍;只存日志正文是 25.00% 对 33.39%,差 1.34 倍。差距的一多半是元数据字段带来的,不是日志正文。如果你的采集链路不像这次一样带着 6 个元数据字段,ES 的实际差距会比主表小不少。
副本没算进去
上面所有数字都是单副本落盘:ES number_of_replicas: 0,Doris replication_num=1,CK 单机没副本。去掉冗余,比的才是引擎自己的压缩能力。
生产上肯定要带副本,可三家参数的计数方式不一样,直接拿来比会差一位:
| 参数 | 默认值 | 实际份数 | |
|---|---|---|---|
| Elasticsearch | index.number_of_replicas | 1 | 2(主分片 + 1 副本),可在线调整 |
| Doris(存算一体) | replication_num | 3 | 3 |
| Doris(存算分离) | replication_num | 1 | 1,持久性由对象存储承担 |
| ClickHouse | 无引擎级设置 | 无 | 由 ReplicatedMergeTree 的集群拓扑决定 |
ES 的参数数的是主分片之外还有几个副本,Doris 数的是一共几份。
按常见的生产习惯折算一下,CK 双副本、Doris 三副本、ES 默认两份,nginx_t1 的实际占盘就变成 CK 50.1%、Doris 127.9%、ES 94.2%,Doris 和 ES 的位置倒过来了。当然这得看部署形态,存算分离的 Doris、用快照而不是副本做冗余的 ES 都不是这么算的,按自己实际的副本策略代进去就行。
全文检索
hot 模式,只算等价查询,跨 5 档 × 2 个数据集,取首次触达 / 中位数(p50,毫秒):
| 用例 | ClickHouse | Doris | Elasticsearch |
|---|---|---|---|
单词(c1_token) | 127.6 / 36.55 | 154.7 / 30.82 | 6.29 / 6.29 |
英文短语(c2_phrase) | 242.9 / 40.17 | 360.1 / 24.70 | 131.5 / 4.63 |
中文短语(c3_cjk) | 139.5 / 36.91 | 540.3 / 22.07 | 330.7 / 3.80 |
多词 AND(c6_multi_and) | 121.7 / 41.29 | 198.0 / 19.04 | 3.8 / 3.45 |
极稀有词,2 命中(c8_rare) | 57.2 / 17.44 | 156.3 / 18.26 | 3.3 / 3.31 |
高选择率(c9_hot) | 84.1 / 17.37 | 142.1 / 17.34 | 3.2 / 3.03 |
索引取反(c4_token_not_index) | 94.2 / 31.38 | 431.1 / 316.58 | 2.3 / 2.48 |
中文索引取反(c5_cjk_not_index) | 144.5 / 37.34 | 674.3 / 329.56 | 364.1 / 2.46 |
多词索引取反(c7_multi_not_index) | 164.6 / 29.88 | 416.1 / 311.88 | 16.6 / 1.94 |
每行是这个用例跨 5 档 2 个数据集的中位数(n=10)。Doris 的 c2_phrase 只有 8 个样本,c3_cjk 和 c5_cjk_not_index 只有 4 个,是剔掉跑不了、比不了的档位以后剩下的。
正向索引查询 ES 全面领先,中位数都是个位数毫秒,CK 和 Doris 在一个量级上。
Doris 的取反类查询明显重一些,在 300 毫秒这个量级,比另两家慢一个数量级。翻 Doris 源码,ColumnPredicate 带了 _opposite 标志,NOT 是能下推到谓词本身的;可它取反的代价会随着「需要确定的行数」往上涨。同一个取反谓词,count(*) 必须把 9995 万行全部定下来,要 286ms;LIMIT 100 凑够 100 行就能停,只要 38ms。CK 和 ES 在同一组对比里取反几乎不花钱。所以也别急着说 Doris 取反最差,如果业务里的取反是「拿最近 N 条」而不是「数一共多少条」,Doris 的代价跟 CK 差不多。
ES 也不是全线最快
按具体的查询组合看,快慢是两个方向都有的,而且两边都有站得住的反例(hot 模式,三批各自的 p50):
| 组合 | ClickHouse | Elasticsearch | 谁更慢 |
|---|---|---|---|
c7_multi_not_scan / messages_d0 / C(全扫类) | 2874 / 2933 / 2957 ms | 13.8 / 6.9 / 7.8 ms | CK 慢约 378 倍(逐批配对 208–427 倍) |
c4_token_not_index / messages_t1 / T(索引取反 + 取原文) | 178.5 / 178.7 / 169.6 ms | 5985 / 5959 / 5910 ms | ES 慢约 33 倍(逐批配对 33–36 倍) |
CK 慢的那条,是因为要把整列读一遍逐字节比对;ES 慢的那条,是取原文的 T 形态叠上它比较重的取反执行路径。两组的三批结果都没有重叠,方向是稳的。整体上 34 对跨系统比较里有 33 对分得出高下,剩下一对是高选择率用例上的 CK 和 Doris,三批结果有重叠,分不出来。
不过生产里很多查询其实是首轮冷查询,而三家的首轮都比中位数高出好几倍。CK 是 3–5 倍,Doris 2–7 倍,ES 在 token 类用例上几乎没差别,可到了中文和短语类,能高出 15–17 倍。
text 索引为什么能在整个 part 内定位候选行,以及建表时的 GRANULARITY 1 为什么会变成一亿,另见 text 索引的 GRANULARITY。
CK 的短语检索是近似匹配
CK 的 text 索引不存 token 位置,所以短语查询只能确认「这几个词都出现过」,确认不了「它们挨在一起」。不同档位的精度还不一样:
| 档位 | 分词器 | 中文短语 | 英文短语 |
|---|---|---|---|
| d0 / t1 / t3 | splitByNonAlpha | 精确(整段中文被切成一个 token) | 近似(无序、不验相邻) |
| t2a | unicode_word | 近似(退化成单字无序 AND) | 近似 |
| t2b | ngrams(3) | 较强的近似(重叠 3-gram 天然编码局部顺序) | 较强的近似 |
这次测试里,近似刚好等于精确,但那是语料的特点帮了忙。探针词是随机生成后注入的,注入点以外不会再出现,「所有词都出现」和「词挨在一起」在这里碰巧是一回事。换成词与词自然共现的真实日志,这个近似就可能误召回。
不走索引,改用 LIKE 也是一条路,就是代价太高。同样覆盖约 9800 万行,LIKE 读了 25.46 GiB,索引谓词只读了 0.091 GiB,读取量差了 280 倍;单条查询 2.1–3.2 秒对 34–45 毫秒,差了大约 62 倍。
| 用例 | LIKE 读取 | 索引谓词读取 | 倍数 |
|---|---|---|---|
| nginx_d0 · 英文短语 | 25.46 GiB | 0.091 GiB | 280× |
| nginx_t2b · 英文短语 | 25.46 GiB | 1.920 GiB | 13.3× |
| messages_d0 · 英文短语 | 12.71 GiB | 0.091 GiB | 140× |
| nginx_d0 · 中文短语 | 25.51 GiB | 0.091 GiB | 280× |
| messages_d0 · 中文短语 | 12.59 GiB | 0.091 GiB | 138× |
好在这一块 ClickHouse 正在补。这次测的 26.3.13.31,文本索引条件只认 hasToken 系列那几个函数,没有任何短语函数。上游后来分三步把这项能力补上了:
| 版本 | 能力 | 索引参与吗 |
|---|---|---|
| 26.3.13.31(本次被测) | 只有 hasToken / hasAnyTokens / hasAllTokens | 无 |
| 26.4 | 新增 hasPhrase(别名 matchPhrase) | 不参与,changelog 写明是暴力搜索 |
| 26.4 稍后 | 索引以 HINT 模式参与 hasPhrase | 只做裁剪,仍需回列校验 |
| 26.7 | 索引可存 token 位置,精确短语匹配直接从索引读取 | 参与 |
26.7 那一项还挂在实验特性下面,得先打开 MergeTree 设置 allow_experimental_text_index_phrase_search(默认关),建索引时再加上 support_phrase_search 参数。这个设计跟 Doris 的 support_phrase 几乎一个样,都是建表时定的索引参数,都是拿索引体积换短语精度。26.7 我这次没测,它的索引会大多少、查得有多快,现在说不上来。要是选型时短语精度是硬要求,值得拿新版本单独测一下。
我推 ClickHouse
以前我写过评测对比,有同事看完问我:看完我更糊涂了,到底该选哪个?这话我记到现在。一篇对比文章,读完了得不出结论,那只能算科普,算不上选型。所以这里我直接说:日志检索,我推 ClickHouse。
我是做 ClickHouse 的,这个结论可能不让人意外,但它不全是屁股决定脑袋。理由一半在数据里。压缩比 CK 全线最紧凑,列存加上可选编码,调优空间也最大;正向索引查询虽然比 ES 慢一个量级,可三四十毫秒对日志检索来说够用了。日志是要长期存的,盘是一直在花的钱,检索快那几十毫秒,很少有人愿意为它多买一倍的盘。
另一半理由,说出来不那么「客观」,但我觉得更重要:我熟 ClickHouse。它的短板我知道,短语是近似匹配,全扫类查询要绕开,默认 LZ4 不调就吃亏,这些边界我心里都有数,出了问题知道往哪查。选一个自己知道边界在哪的东西,比选一个看起来什么都强的东西踏实。Doris 在这次测试里有几项看着确实不错,默认就用 ZSTD,不调也有个像样的起点,可我也清楚,这里面可能有一部分只是因为我用得不深,很多坑还没碰上。
当然,推 CK 不等于无脑上 CK。碰到下面几种情况,我会老老实实换别家。
短语必须精确、语料里的词又是自然共现的,比如审计、合规检索。在 CK 26.7 的短语索引转正、体积代价测清楚之前,我会选 ES,或者开了 support_phrase 的 Doris。
查询以交互式、低延迟的正向检索为主,存储预算又不是第一约束。ES 的个位数毫秒是倒排索引存位置、读取路径最短决定的,CK 怎么调参都追不上。它的存储代价最高,但如果链路不带一堆元数据字段,实际差距比主表小得多;用不着整条取回原文和按 ID 改写的话,关掉 _source 或者换成 synthetic _source,压缩比也能压到接近 CK 的水平,后者要企业版或试用许可证。
团队压根不打算调优,也没人对 CK 熟。这种情况 Doris 更省心,d0 和 t1 只差一两个百分点;CK 默认的 LZ4 在 messages 上是 69.66%,得换成 ZSTD 才降到 47.80%,不调就落在 Doris 后面。只是 Doris 的取反类查询偏重,support_phrase 关掉以后短语查询是直接报错而不是降级,这两点上线前要自己验一下。
最后说几句这次测试的局限,引用里面的数字时心里要有数。这是单机测试,并发一直是 1,没测写入,延迟数字推不到集群 QPS 上,写入吞吐要是关键约束得另外测。语料是合成的,短语近似等于精确这件事,只在这份语料上成立。采集时刻这一列的值只跨了 24–28 分钟,三家的时间列压缩比都会显得偏高,好在对三家是一样的,不影响互相比较。冷查询的数字每轮都清了页缓存,但仍有一半左右的记录首轮明显偏慢,说明页缓存之外还有东西被预热了,所以它代表的是稳定状态下的冷,不是第一次访问的真实代价。