ClickHouse 集群部署拓扑对比:为什么推荐「一机一副本」
5983 字 · 约 16 分钟
概述
不少人私下问我,ckman为什么不支持clickhouse集群混合部署的方式,我通常给出的答案是运维复杂,但是感觉并没有说透,很多人会拿网上别人写的混合部署的文章来反驳我,说:你看,为什么别人推荐这么部署?
此时我也唯有一声长叹息。看来,有必要放放干货了。
关于clickhouse集群的部署拓扑方案,业界众说纷纭,有很多种技术可达的思路。但我一直坚持一点:技术可达,不等于最佳实践。 本文就来聊聊一些常见的clickhouse集群部署方式,以及它们各自的优劣。
主流的部署方案一般有两种,即一机一副本和环形部署。
所谓一机一副本,就是每台服务器只承载一个分片的副本,官方推荐的部署方式、ckman、clickhouse_sinker等生态应用都是基于这种部署方式来做的。
环形(circular)部署,指的是每台服务器同时承载两个(或两个以上)分片的副本,如一台服务器,既是S1R1,同时又是S3R2。
除了上述两种方式,还有一种更非主流的部署方式,我称之为轮转多集群方式。这种方式的核心思想是同一批节点定义多套 cluster,副本配对方式各不相同,不同表挂不同 cluster。
三种部署拓扑玩法介绍
我们以 2 副本集群为例。
方案 1:一机一副本
N 台机器,N/2 个分片,每个分片的两个副本落在两台独立的机器上。
图中节点是物理机,一条边表示一个分片:边的两端就是这个分片的两个副本所在的机器。3分片2副本需要6台机器。
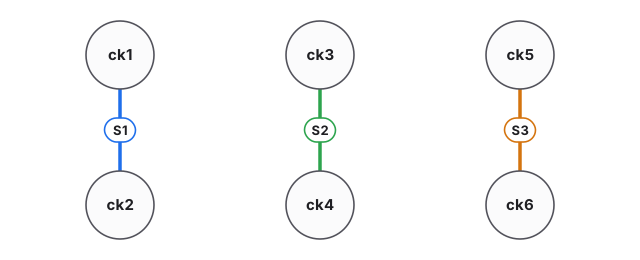
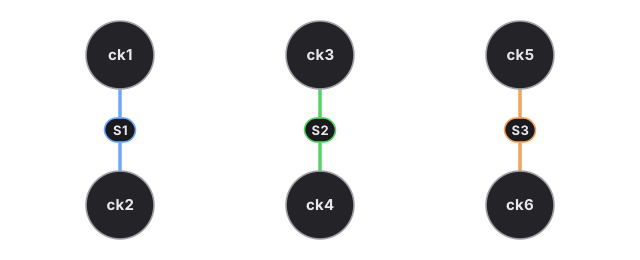
它在clickhouse的配置中如下表示:
<clickhouse>
    <remote_servers>
        <test>
            <secret>foo</secret>
            <shard>
                <internal_replication>true</internal_replication>
                <replica>
                    <host>192.168.122.101</host>
                    <port>9000</port>
                </replica>
                <replica>
                    <host>192.168.122.102</host>
                    <port>9000</port>
                </replica>
            </shard>
            <shard>
                <internal_replication>true</internal_replication>
                <replica>
                    <host>192.168.122.103</host>
                    <port>9000</port>
                </replica>
                <replica>
                    <host>192.168.122.104</host>
                    <port>9000</port>
                </replica>
            </shard>
            <shard>
                <internal_replication>true</internal_replication>
                <replica>
                    <host>192.168.122.105</host>
                    <port>9000</port>
                </replica>
                <replica>
                    <host>192.168.122.106</host>
                    <port>9000</port>
                </replica>
            </shard>
        </test>
    </remote_servers>
</clickhouse>
方案 2:环形部署
这就是很多人谈论的混合部署方案。它的核心思想是单台服务器承担多个分片的不同副本。N 台机器,N 个分片。机器 i 承载分片 i 的 R1 与分片 i-1 的 R2,首尾相接成环。这样同样是3分片2副本,仅需3台机器即可完成部署。
每台机器承载的副本:
| 机器 | ck1 | ck2 | ck3 |
|---|---|---|---|
| 副本 | S1R1,S3R2 | S2R1,S1R2 | S3R1,S2R2 |
其拓扑如下图所示:
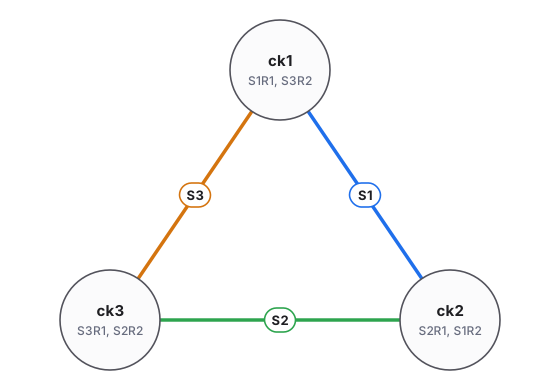
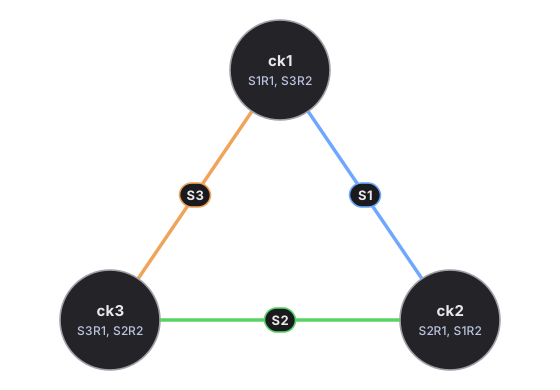
常见实现有两种。一种是单实例多 database,一个 clickhouse-server 进程,两个 database 分别使用不同的 {shard}/{replica} 宏,remote_servers 中每个副本配置 default_database,并必须 internal_replication=true。另一种是多实例多端口,一台机器跑两个 clickhouse-server 进程,各自独立的端口、数据目录、配置。
配置文件一般长这样(以单实例多 database 为例,ck1~ck3 分别是 192.168.122.101~103,r1、r2 两个库分别放每台机器上的 R1 和 R2):
<clickhouse>
    <remote_servers>
        <test>
            <secret>foo</secret>
            <shard>
                <internal_replication>true</internal_replication>
                <replica>
                    <host>192.168.122.101</host>
                    <port>9000</port>
                    <default_database>r1</default_database>
                </replica>
                <replica>
                    <host>192.168.122.102</host>
                    <port>9000</port>
                    <default_database>r2</default_database>
                </replica>
            </shard>
            <shard>
                <internal_replication>true</internal_replication>
                <replica>
                    <host>192.168.122.102</host>
                    <port>9000</port>
                    <default_database>r1</default_database>
                </replica>
                <replica>
                    <host>192.168.122.103</host>
                    <port>9000</port>
                    <default_database>r2</default_database>
                </replica>
            </shard>
            <shard>
                <internal_replication>true</internal_replication>
                <replica>
                    <host>192.168.122.103</host>
                    <port>9000</port>
                    <default_database>r1</default_database>
                </replica>
                <replica>
                    <host>192.168.122.101</host>
                    <port>9000</port>
                    <default_database>r2</default_database>
                </replica>
            </shard>
        </test>
    </remote_servers>
</clickhouse>
宏是服务器级的,一台机器只能有一组 {shard},可它身上偏偏有两个分片,所以只能给两个库各定义一套。以 ck1 为例:
<macros>
    <r1_shard>01</r1_shard>
    <r2_shard>03</r2_shard>
    <r1_replica>ck1-r1</r1_replica>
    <r2_replica>ck1-r2</r2_replica>
</macros>
建表时两个库各建一遍,ZooKeeper 路径用各自的宏;分布式表的库名留空,让 default_database 去决定落到哪个库:
CREATE TABLE r1.tbl ON CLUSTER test ( ... ) ENGINE = ReplicatedMergeTree('/clickhouse/tables/{r1_shard}/tbl', '{r1_replica}') ...;
CREATE TABLE r2.tbl ON CLUSTER test ( ... ) ENGINE = ReplicatedMergeTree('/clickhouse/tables/{r2_shard}/tbl', '{r2_replica}') ...;
CREATE TABLE default.dist_tbl ON CLUSTER test AS r1.tbl ENGINE = Distributed('test', '', 'tbl', rand());
这里任何一处写错,比如某台机器的 r2_shard 填错了,两个本不相干的分片就会在 ZooKeeper 上共用一条副本路径,数据互相串,而且不会报错。internal_replication 也必须是 true,否则分布式表会自己往两个副本各写一份,副本之间又会再互相复制一遍,数据就重复了。
多实例多端口的配置思路一样,只是把 default_database 换成不同的 <port>,宏也不用分两套,两个实例各有自己的配置文件。代价是每台机器上要维护两套配置、两个数据目录、两个服务。
用这种方式,理论上可以用有限台机器部署任意分片规模的集群。但是代价是一旦机器用满(这种情况下更容易用满),扩容节点将变得几乎不可能。
它这种方式和Kafka以及Doris那种拓扑还是有所不同的,ck的拓扑在集群部署阶段就已经决定好了,而kafka、doris则是在创建topic/表的时候才知道具体有多少个分区,多少副本。
方案 3:轮转多集群
这种骚操作我第一次听到简直惊为天人,居然还能这么玩。
它的思路是同一批节点定义多套 cluster,每套 cluster 内部都是"一机一副本",但副本配对方式不同;建表时不同的表指定不同的 cluster。以 4 节点为例:
| cluster | S1 | S2 | 挂载的表 |
|---|---|---|---|
| cluster1 | tbl1 | ||
| cluster2 | tbl2 | ||
| cluster3 | tbl3 |
下图中节点是物理机,一条边表示两台机器在某套 cluster 中互为同一分片的副本,颜色区分 cluster。3 套 cluster 把 4 台机器之间所有 6 种两两组合都占满了,所以任意两台同时故障,总有一张表的某个分片不可用(见下面故障域与可用性一节):
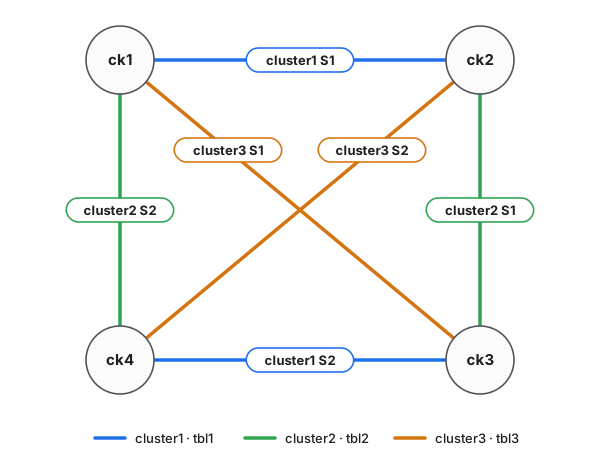
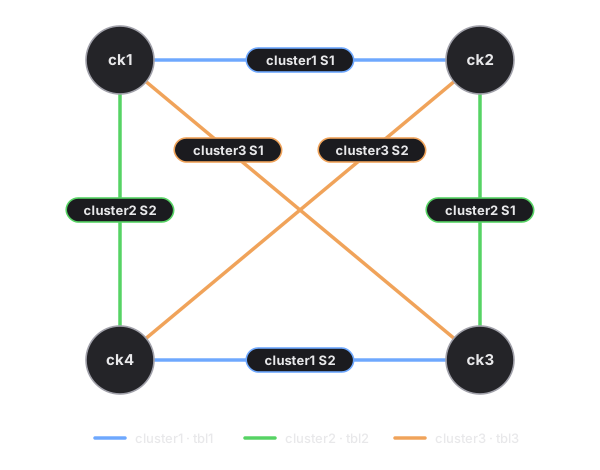
每套 cluster 的分片编号各不相同,所以宏也得一套 cluster 一组。以 ck1 为例,它是 cluster1 的 S1、cluster2 的 S2、cluster3 的 S1:
<macros>
    <c1_shard>01</c1_shard>
    <c2_shard>02</c2_shard>
    <c3_shard>01</c3_shard>
    <replica>ck1</replica>
</macros>
建表时,这样操作:
CREATE TABLE table1 ON CLUSTER cluster1 .... ENGINE=ReplicatedMergeTree('/clickhouse/tables/cluster1/{c1_shard}/{database}/{table}', '{replica}') ....
CREATE TABLE dist_table1 ON CLUSTER cluster1 as table1 ENGINE=Distributed('cluster1', 'default', 'table1', rand());


CREATE TABLE table2 ON CLUSTER cluster2 .... ENGINE=ReplicatedMergeTree('/clickhouse/tables/cluster2/{c2_shard}/{database}/{table}', '{replica}') ....
CREATE TABLE dist_table2 ON CLUSTER cluster2 as table2 ENGINE=Distributed('cluster2', 'default', 'table2', rand());

...
ZooKeeper 路径里的分片宏千万别漏,也别用错。漏了,同一套 cluster 的两个分片就共用一条路径,4 台机器存的是同一份数据;用错了,比如 table2 用了 {c1_shard},这张表就按 cluster1 的配对去复制,和 dist_table2 以为的分片对不上。
单独看每一张表,它都是一机一副本,但是所有表各自为政,数据全部混乱分布在所有节点。它的好处是在确保单机故障影响最小的同时,尽最大可能用满机器资源。包括本地join也有解决方案:把需要本地join的表指定相同的cluster即可。但是带来的问题是维护复杂度爆炸性上升,ckman之类的运维工具已经满足不了,节点扩缩容也十分困难,只能靠手工运维。
三种方案横向对比
| 维度 | 方案 1 一机一副本 | 方案 2 环形 | 方案 3 轮转多集群 |
|---|---|---|---|
| 单机故障影响的分片数 | 1 | 2 | 每张表 1 个,但涉及多张表的不同分片 |
| 双机故障导致不可用的概率(N=6) | 20% | 40% | 随轮转套数上升,最坏 100% |
| 正常状态单查询延迟 | 一个查询只用到一半机器 开启 enable_parallel_replicas 后可用满副本 | 用满所有机器 | 同方案 1 |
| 单机故障后单查询延迟 | 基本不变 | 接近翻倍 | 基本不变 |
| 故障后负载分散程度 | 集中到一台搭档 | 集中到两台邻居(且叠加) | 分散到多台 |
| 单表内资源隔离 | 天然隔离 | 两分片共享 CPU / 内存 / merge 池 / page cache / 网卡 | 天然隔离 |
| 跨表同分布(本地 JOIN、MV) | ✅ | ✅ | ❌ 静默出错 |
| clickhouse_sinker 等写本地表工具 | ✅ | ✅ | ❌ 静默写错分片或无法连接 |
| ckman / clickhouse-operator 支持 | ✅ | ❌ | ❌ |
| 配置复杂度 | 低 | 高(宏、default_database、internal_replication) | 高(多套宏、多套 cluster) |
| 扩容 | 加两台即可 | 需重排环 | 每套 cluster 都要重新规划 |
| 机器数不为偶数时(如 3 台) | 不方便 | 对称解 | 视情况 |
逐项分析
故障域与可用性
副本主要是为了保障什么?无非两个方面:数据冗余和高可用。即:挂掉一台服务器后,数据不丢,集群仍能对外提供服务。所以故障域和可用性在参考维度里的分量最重。
单机故障
单机故障时,方案 1 是 1 个分片降为单副本,方案 2 是 2 个分片同时降为单副本。
双机同时故障
设 N 台机器、2 副本,任取两台同时故障,共 C(N,2) = N(N-1)/2 种组合。某分片两个副本全挂即该分片不可用:
| 部署 | 致命组合数 | 概率 | N=4 | N=6 |
|---|---|---|---|---|
| 方案 1 | N/2 | 1/(N-1) | 33% | 20% |
| 方案 2(环形) | N(任意相邻两台) | 2/(N-1) | 67% | 40% |
| 方案 3(k 套互不重叠的配对) | k·N/2 | k/(N-1) | k=2: 67%;k=3: 100% | k=3: 60%;k=5: 100% |
结论:同样的硬件、同样的副本数,方案 2 的风险是方案 1 的 2 倍(节省下来的资源要以故障发生时交学费的方式还回去);方案 3 的风险随轮转套数线性上升。
这并不是 ClickHouse 特有的现象。Copysets 论文(Cidon et al., Copysets: Reducing the Frequency of Data Loss in Cloud Storage, USENIX ATC 2013)系统论证过:副本组合(copyset)越分散,任意多节点同时故障命中某份数据的概率越高;代价换来的是单次事故影响的数据量更小。HDFS、RAMCloud 的随机副本放置正是因此被诟病。
对 ClickHouse 而言,"影响的数据量更小"几乎没有意义:分布式查询只要有一个分片不可用就整体报错(除非开启 skip_unavailable_shards 并接受不完整结果)。对业务而言,任意一张表的任意一个分片不可用,就是故障。
滚动重启 / 升级
滚动重启时,方案 1 每次重启一台,1 个分片短暂处于单副本;方案 2 每次重启一台,2 个分块同时处于单副本,且邻居节点负载翻倍;方案 3 每次重启一台,多张表的不同分片同时处于单副本。
性能:正常状态与降级状态
分布式查询的延迟由最慢的分片决定。
正常状态
方案 1 的一个查询对每个分片只选一个副本,只用到一半机器,另一半机器服务其它并发查询。但是CK从v24.10开始把 parallel replicas 提升到了 Beta,并给开关起了个别名 enable_parallel_replicas(旧名 allow_experimental_parallel_reading_from_replicas,默认关闭),它能够在分片内分拆任务到各个副本间并行执行,每个分片最多用 max_parallel_replicas 个副本,而且任务是动态分配的,降级时更加平滑。官方测试千亿数据能做到秒级返回。详见:9000+ 核跑并行:ClickHouse 数据库让任意查询语句肆意奔驰
方案 2 每台机器都承担一个分片的查询工作,单查询用满全部机器,这是方案 2 最主要、也最真实的优点,在低并发、看重单查询延迟的分析场景中效果明显。
单机故障后
方案 1 的故障机分片由搭档接手,搭档原本只负责这一个分片,单查询延迟基本不变,只是该分片的并发能力减半。方案 2 机器 i 故障后,分片 i 和分片 i-1 分别由两个邻居接手,每个邻居要同时扫描两个分片的数据,几乎所有查询都会涉及这两个邻居,集群整体查询延迟接近翻倍。方案 3 每张表的行为同方案 1,且不同表的降级负载落在不同机器上,降级最平滑,这是方案 3 的真实优点。
资源隔离
方案 2 中两个分片共享同一台机器的全部资源:
| 资源 | 为什么会互相干扰 |
|---|---|
| merge / mutation 线程 | background_pool_size 是服务器级的。分片 A 的大 merge 占满线程池,分片 B 的 merge 只能排队,part 堆积,最终可能触发 Too many parts |
| 内存 | max_server_memory_usage、mark cache、uncompressed cache 全局共享 |
| page cache | 操作系统层面共享,一个分片的大查询会把另一个分片的热数据挤出 |
| CPU | 查询线程、写入时的排序压缩、解压缩,都在同一个进程里竞争 |
| 网络 | 副本间 fetch part、分布式查询结果汇总,共用同一块网卡 |
| 磁盘 IO | 两个分片的写入与 merge 在同一组磁盘上竞争 |
此外,监控指标多是主机或进程维度,出问题时很难判断是哪个分片引起的。
跨表同分布(方案 3 特有)
方案 1、2 中所有表的分片布局一致:只要 sharding key 相同,同一个 key 的数据就落在同一台机器上。很多 ClickHouse 用法依赖这一点。方案 3 打破了它:
本地 JOIN / IN 会出问题,tbl1 与 tbl2 即使使用相同的 sharding key,同一个 key 也落在不同的物理机器上,distributed_product_mode='local'、手写 _local 表 JOIN 等写法会少数据但不报错。物化视图也一样,MV 挂在 tbl1 的本地表上,写入的是本机的 tbl2 本地表,但本机在 cluster2 中属于另一个分片,数据进了错误的分片,总量对得上,分片语义是错的,基于分片的去重、聚合下推都会出错。依赖"分片键 → 分片"映射的优化(optimize_skip_unused_shards、distributed_group_by_no_merge)同样失效,每张表的映射不同,任何人用错 cluster 名,结果都会出错。
工具链兼容
clickhouse_sinker(直接写本地表)
sinker 的设计哲学是:每个分片只连接一个副本,启动时随机挑选,之后保持不变,只有写失败才切到下一个副本,切走后不会切回;批次按 batchNum % 分片数 轮询分配,配置了 shardingKey 时按 key 固定分片;分片连接 clusterConn 是进程级全局变量,同一进程内所有 task 共享同一套副本选择;所有主机使用同一个 chCfg.Port,INSERT 语句只有一份 INSERT INTO db.table,对所有分片相同;拓扑通过 system.clusters 按单个 cluster 名发现。
由此推出:
先看方案 2 的正确性问题。单实例多库时,sinker 对所有分片发同一个 db.table,往分片 i 的副本机器 i+1 上写时,实际写入的是机器 i+1 上该库对应的分片(即分片 i+1),数据静默进入错误的副本组。无 shardingKey 时表现为分布倾斜;有 shardingKey 时破坏"同 key 同分片"语义,ReplacingMergeTree 去重、本地 JOIN 等随之出错。多实例多端口时,所有主机共用一个 Port,在 Hosts 中写成 ip:9001 会被拼成 ip:9001:9000,无法连接。
再看方案 2 的负载与故障处理。写入副本承担排序、压缩、生成 part 的 CPU 开销,其它副本只 fetch。方案 1 中每台机器最多是 1 个分片的写入副本;方案 2 中两个分片各自随机选择,某台机器有 1/4 的概率同时成为两个分片的写入副本,承担双倍写入。由于 clusterConn 是进程级的而 sinker 进程通常只有几个,这种倾斜难以被平均掉。机器 X 故障时,分片 X 切到 X+1,分片 X-1 切到 X-1,若 X+1 本就是分片 X+1 的写入副本,它现在承担两个分片的写入,与性能一节的查询翻倍叠加在同一台机器上。X 恢复后连接不会切回,倾斜一直持续到 sinker 重启。方案 1 同样会粘住,但单机最坏只承担 1 个分片的写入,不会恶化。相邻两台同时故障导致某分片全部副本不可用时(概率是方案 1 的两倍),无 shardingKey 时可借助 SkipUnavailableShards 改投其它分片;有 shardingKey 时只能重试,消费积压。
方案 3 的话,sinker 的 cluster 是进程级配置,每套 cluster 必须单独部署一组 sinker 进程。如果误把 tbl2 的任务放进 cluster1 的进程,启动时会因在 cluster1 上找不到对应的分布式表而报错,不会静默写错,但部署与运维成本成倍增加。
ckman
ckman 按"一节点一实例"建模,不支持方案 2 的多实例或单实例多库部署。ckman生成的 remote_servers 只包含本集群(以及逻辑集群),方案 3 的轮转 cluster 需要手工维护,且可能在 ckman 下一次下发配置时被覆盖,同一批节点也无法纳入多个 ckman 集群管理。
业界其它工具
Altinity clickhouse-operator 按"一个 Pod 一个副本"建模,ClickHouse Cloud 同样是一节点一副本。选择方案 2、3 意味着工具支持、社区经验、问题排查都需要自行兜底。
运维复杂度
| 事项 | 方案 1 | 方案 2 | 方案 3 |
|---|---|---|---|
| 宏 | 每台一组 {shard}/{replica} | 每个库或每个实例一组 | 每套 cluster 一组,如 {c1_shard}、{c2_shard} |
| ZK 路径 | 统一模板 | 按库区分,选错即副本路径冲突 | 按表选宏,选错即复制错乱 |
| 建表 | 统一 cluster | 需正确的 database 与 storage_policy | 每张表需决定 cluster |
| 扩容 | 加两台,新分片 | 拆开相邻关系、重排整个环 | 每套 cluster 都要重新规划 |
| 排障 | 主机即分片 | 需区分同机两个分片 | 先查"这张表在哪套拓扑上" |
方案 2、3 的优点与应对
公允起见,方案 2、3 的支持者通常有以下理由,下面给出在方案 1 上的替代做法。
| 理由 | 在方案 1 上的替代 |
|---|---|
| 单查询能用满所有机器(方案 2) | 使用 parallel replicas(enable_parallel_replicas + max_parallel_replicas,24.10 起为 Beta,老版本里开关叫 allow_experimental_parallel_reading_from_replicas),让单查询同时读取同一分片的多个副本 |
| 故障时降级负载更分散(方案 3) | 为每台机器预留足够的余量,使搭档节点能独立承担一个分片的全部负载;对可用性要求更高时改为 3 副本 |
| 机器数不凑整,如 3 台(方案 2) | 3 台可部署 1 分片 × 3 副本;数据量确实需要分片时,优先补齐到 4 台 |
| 恢复时可从多台源并行拉数据(方案 2、3) | 收益有限:单机数据量相同,恢复瓶颈通常在目标机的磁盘与网络 |
只有在机器数量受限、无法补齐,且业务以低并发大查询为主、对故障期间的延迟不敏感时,方案 2 才是可以接受的折中。此时的建议是:为每个分片分配独立磁盘,缩小磁盘故障域;不使用 clickhouse_sinker 等直接写本地表的工具,自研其他写入中间件,或确保工具能感知 database 与端口;把双倍故障风险明确写进可用性评估。
推荐方案的落地要点
副本数默认 2 副本,对可用性要求高的场景用 3 副本,3 副本下双机同时故障不会导致任何分片不可用。容量规划按"单机故障后搭档承担全部读流量"预留 CPU 与 IO 余量,正常状态下单副本的读负载建议不超过约 50%。副本分布上,同一分片的副本放在不同机架、不同电源域,或在云上放在不同可用区,在方案 1 中这条规则简单直接,在方案 2、3 中则需要额外推导。单查询性能方面,对单查询延迟敏感的场景评估 parallel replicas,而不是改用环形部署。磁盘方面,单实例内多块盘用 JBOD 存储策略统一管理,充分利用全部磁盘带宽。工具链方面,ckman 部署与管理、clickhouse_sinker 写本地表、所有表统一一套 cluster,保持"一个 host:port 对应一个分片、所有表同分布"的前提。
总结
所以有人问:为什么ckman不能支持环形部署的混布方式?
还是那句话,合格的运维工具不会穷举技术上的可能性,而是给一套维护最简单,生产上最可靠的最佳实践,情愿多花一些冗余资源,也不想换来一次线上无法恢复的故障和无休无止的通宵排障。
方案1的优点显而易见。可靠性上,同样的机器、同样的副本数,方案 2 在双机故障时出现分片不可用的概率是方案 1 的 2 倍,方案 3 随轮转套数上升,最坏达到 100%(故障域与可用性一节,纯组合数学)。性能上,方案 2 的单机故障会让邻居节点的查询与写入负载同时翻倍,集群整体查询延迟接近翻倍,方案 1 的单查询延迟基本不变(性能一节)。正确性与生态上,直接写本地表的工具(如 clickhouse_sinker)、ckman、本地 JOIN、物化视图都默认"一个 host:port 只对应一个分片、所有表同分布",方案 2、3 打破了这个假设,后果是数据静默写错分片或查询静默少数据(跨表同分布、工具链兼容两节)。
方案 2、3 的真实优点,单查询能用满所有机器、故障时降级负载更分散,都存在,但前者可以通过 parallel replicas 在方案 1 上获得,后者可以通过容量冗余或 3 副本更安全地获得(方案 2、3 的优点与应对一节)。
参考
- Asaf Cidon et al. Copysets: Reducing the Frequency of Data Loss in Cloud Storage. USENIX ATC 2013.
- ClickHouse 文档:Distributed 表引擎、
internal_replication、skip_unavailable_shards、parallel replicas、存储策略(storage_policy)。 - clickhouse_sinker 源码(commit
d6fb252):pool/conn.go、output/clickhouse.go、discovery/discovery.go。 - ckman 源码:
ckconfig/metrika.go。
相关:扩容之后为什么不自动做数据均衡 · 同一条 SQL 每次查出来不一样 · ckman · clickhouse_sinker